Una tienda online puede tener tráfico suficiente y seguir perdiendo rentabilidad en cada visita. En España, el benchmark más reciente sitúa la conversión media del e-commerce en 1,22%, con un intervalo de normalidad entre 1,01% y 1,43%, según el benchmark digital español basado en implementaciones reales de analítica. El problema, por tanto, no suele ser conseguir otra visita, sino evitar que la visita actual abandone una página, un formulario o un checkout que no responde a sus expectativas.
La aplicación del CRO, o optimización de la tasa de conversión, convierte ese problema en un sistema de trabajo. No consiste en cambiar botones al azar, copiar diseños de competidores ni perseguir un uplift aislado. Consiste en observar el comportamiento, formular hipótesis, probar cambios y decidir con métricas conectadas al ingreso, al lead cualificado y al coste por adquisición.
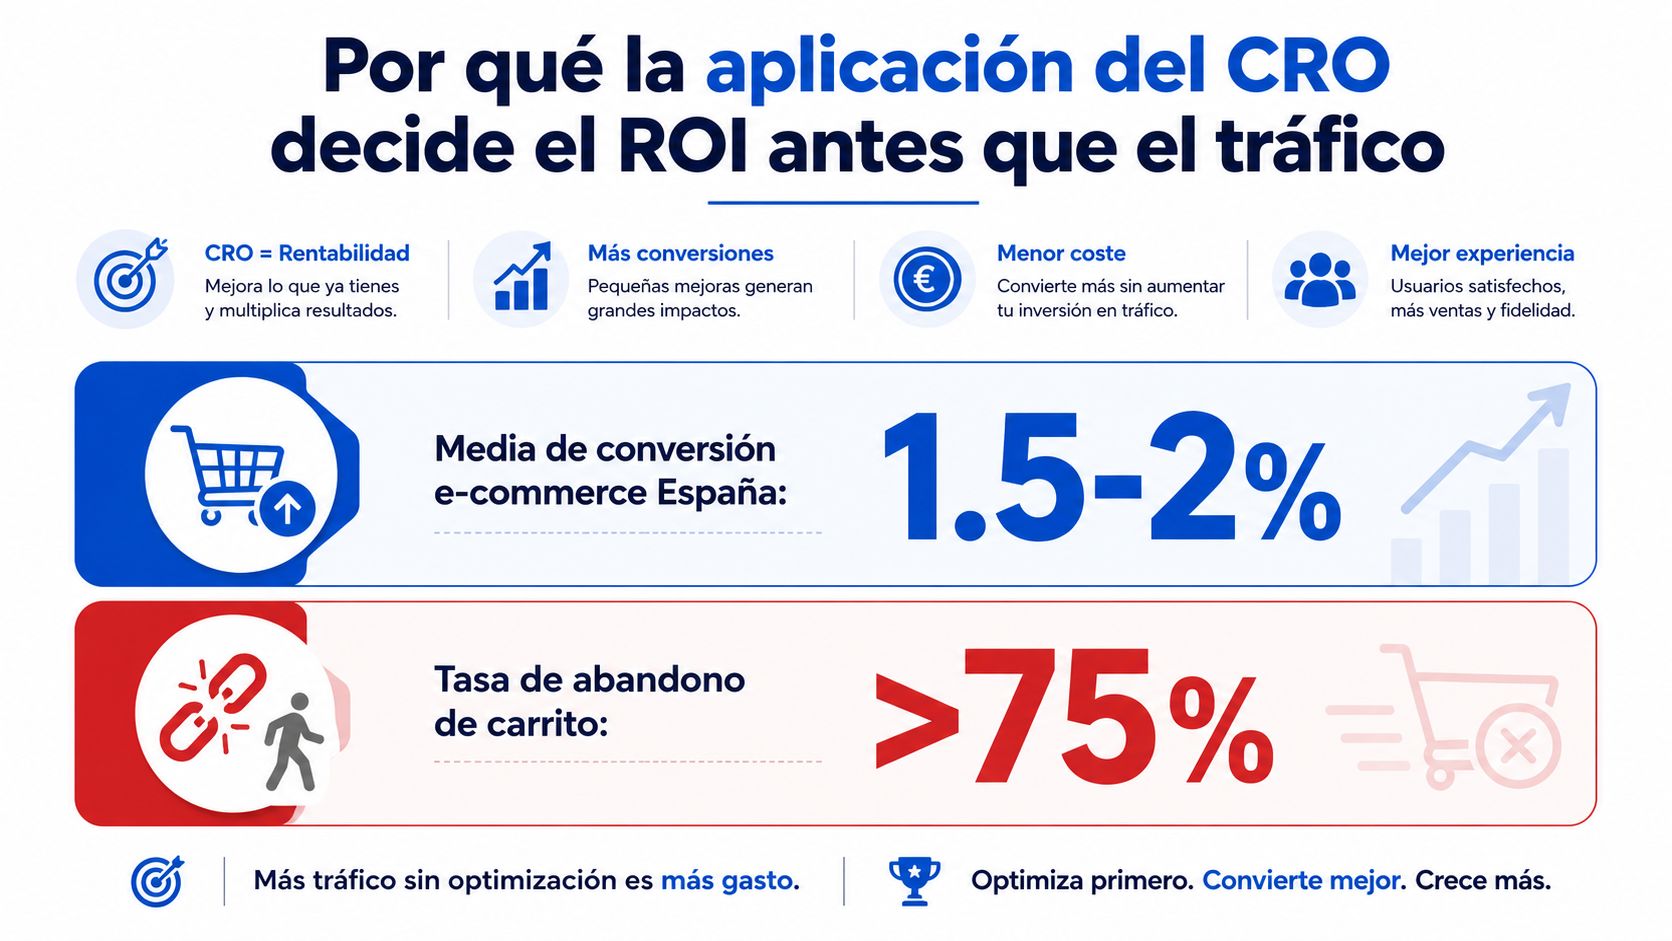
Por qué la aplicación del CRO decide el ROI antes que el tráfico
El benchmark español no debe convertirse en un objetivo universal. El propio análisis señala que la referencia depende del sector, del dispositivo y del recorrido de compra. Aun así, una conversión media del 1,22% muestra una realidad operativa: pequeñas fricciones dentro del embudo pueden afectar a una proporción amplia de las visitas, incluso cuando las campañas atraen usuarios con intención.
Un dato histórico de Flat 101 difundido por Orienteed sobre conversiones en e-commerce español refuerza esa lectura: las visitas que utilizan el buscador interno convierten un 317% mejor de media en el estudio citado. La conclusión no es que exista una solución universal, sino que elementos como la búsqueda interna, la arquitectura de compra y el checkout merecen analizarse antes de aumentar inversión publicitaria.
El embudo antes que el presupuesto
Una campaña puede atraer clics relevantes y perderlos después por una propuesta de valor confusa, una página lenta, un formulario demasiado exigente o un coste de envío inesperado. Escalar ese tráfico sin resolver la fuga eleva el volumen de abandono y hace más difícil distinguir un problema de adquisición de un problema de experiencia.
En B2B, el mismo principio aparece con formularios, agendas comerciales y páginas de servicio. Un visitante puede entender la oferta y aun así no solicitar contacto porque no sabe qué ocurrirá después, cuánto tardará la respuesta o qué información tendrá que entregar. En e-commerce, la promesa incluye también entrega, devoluciones, seguimiento y disponibilidad.
Regla de rendimiento: antes de pedir más presupuesto para captación, hay que demostrar que las páginas y los pasos críticos convierten de forma coherente con la intención que ya llega.
La secuencia correcta es sencilla: identificar la caída principal, estimar su impacto económico, proponer un cambio verificable y medirlo contra una métrica de negocio. Cada mes sin un backlog priorizado deja sin explotar el valor de las visitas existentes. El CRO no sustituye al SEO ni al paid media, pero impide que ambos canales alimenten un recorrido roto.
Auditoría inicial del embudo con datos y comportamiento real
Una auditoría útil combina dos fuentes que suelen analizarse por separado: datos cuantitativos y comportamiento observado. Analytics indica dónde cae el usuario; la reproducción de sesiones ayuda a entender por qué. Si solo se revisan informes agregados, el equipo puede detectar una anomalía sin encontrar la fricción que la provoca.
La primera capa revisa el recorrido completo. En GA4, Mixpanel o Heap conviene comprobar visitas a páginas de entrada, interacción con producto o servicio, inicio de formulario, envío, carrito, inicio de checkout, pago y página de confirmación. Cada evento debe tener nombre, parámetros, condiciones de activación y una relación clara con la métrica principal.
La radiografía cuantitativa
El análisis debe cruzar tres dimensiones:
- Paso del embudo: localiza la caída más pronunciada y separa problemas de página de problemas de proceso.
- Dispositivo: compara móvil, escritorio y otros entornos sin asumir que un diseño responsive resuelve la experiencia.
- Fuente e intención: separa marca, búsqueda genérica, campañas, afiliación, social y tráfico directo para detectar visitas con comportamientos distintos.
También conviene comprobar la calidad del tracking. Un descenso aparente puede proceder de un evento que dejó de dispararse, de una redirección que rompe la sesión o de una página de confirmación que no carga correctamente. La auditoría debe revisar además duplicados, consentimiento, atribución y coherencia entre plataforma publicitaria y analítica.
La capa cualitativa
Los mapas de calor y las grabaciones de sesión aportan señales que un embudo no muestra. Hotjar, Microsoft Clarity y FullStory pueden ayudar a localizar clics repetidos, intentos sobre elementos no interactivos, desplazamientos incompletos, campos problemáticos y contenido que recibe poca atención.
La revisión debe centrarse en páginas con responsabilidad directa sobre la conversión:
- Landing: correspondencia entre anuncio, intención y propuesta de valor.
- Categoría: filtros, ordenación, disponibilidad y búsqueda interna.
- Producto o servicio: beneficios, prueba, precio, objeciones y llamada a la acción.
- Carrito y checkout: costes, métodos de pago, devoluciones, errores y confianza.
- Formulario B2B: campos, validación, mensajes de error y expectativa posterior.
- Confirmación: siguiente paso, seguimiento y transferencia correcta al CRM.
La guía de flujo de usuario para analizar recorridos digitales sirve como referencia para representar rutas reales, no solo la navegación que el equipo espera que ocurra.
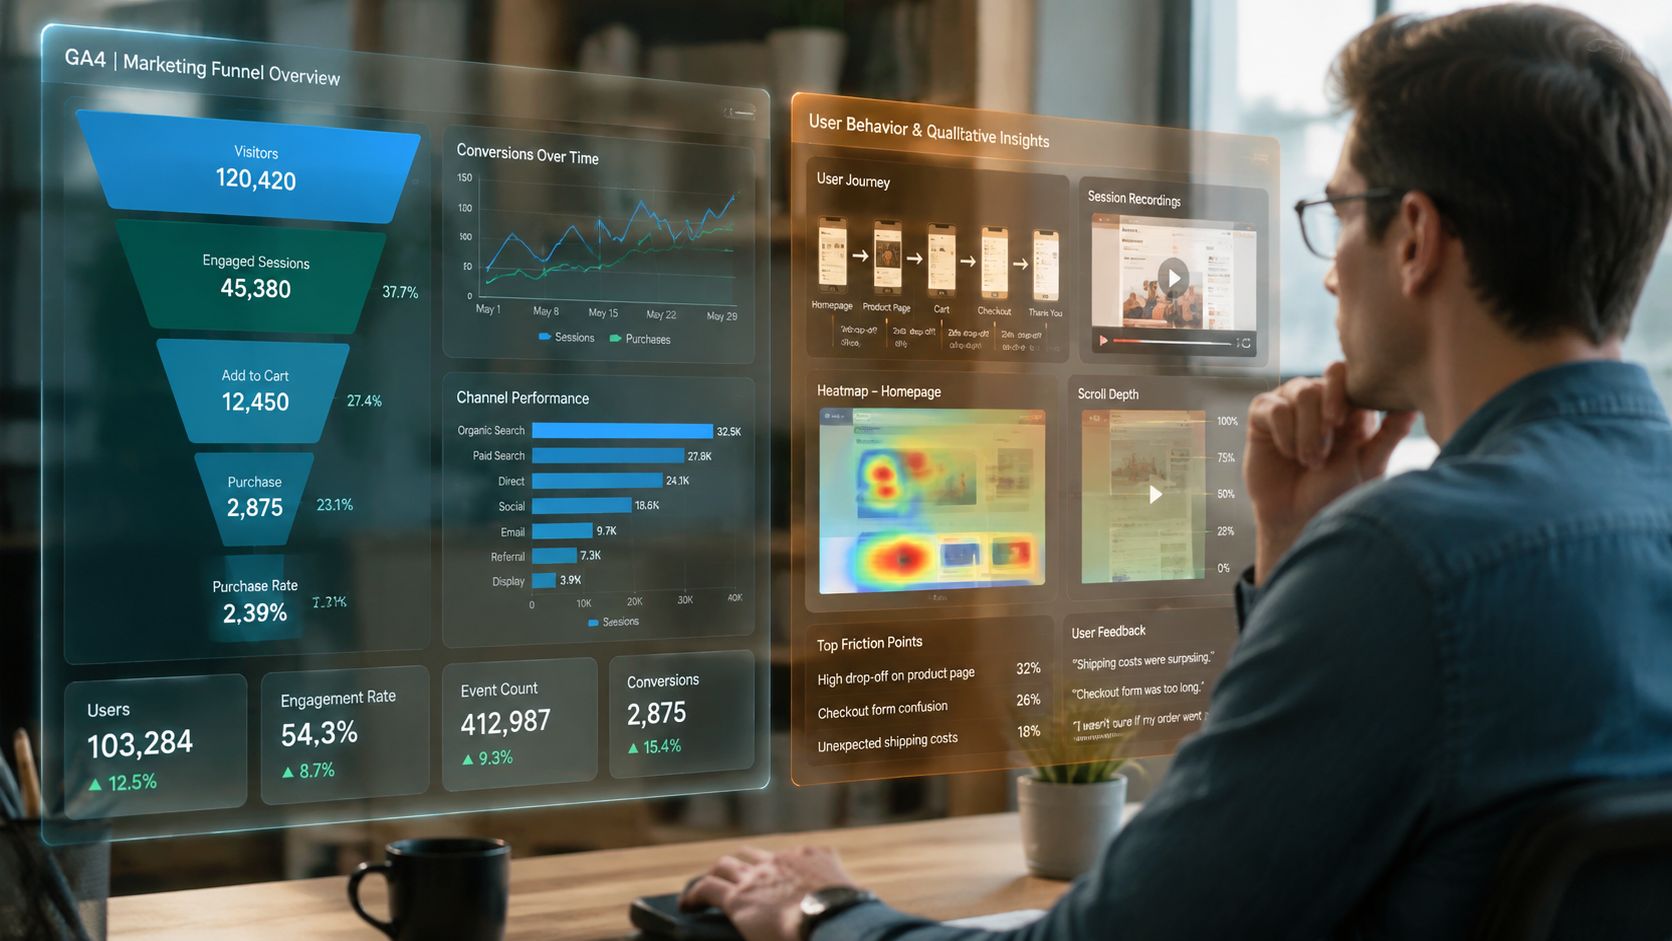
El resultado final debe ser una lista de fugas con evidencia. “La landing no convierte” no es un hallazgo suficiente. “Los usuarios móviles llegan al formulario, interactúan con un campo concreto y abandonan después de un mensaje de validación” sí permite diseñar una hipótesis.
¿Sabes dónde cae el embudo, pero no qué cambio priorizar?
Una auditoría puede cruzar analítica, comportamiento, landing y calidad del lead para convertir las fugas en un backlog de acciones medibles.
Cómo transformar hallazgos en hipótesis priorizables
Un hallazgo describe el problema. Una hipótesis propone una explicación que puede probarse. Sin ese paso, el equipo confunde observación con solución y termina lanzando cambios visuales difíciles de interpretar.
La estructura más práctica es IFE:
Si se cambia X, entonces mejorará Y, porque Z.
Por ejemplo: si se muestran los gastos de entrega antes del checkout, entonces aumentará la finalización de compra, porque el usuario podrá valorar el coste total antes de introducir sus datos. La hipótesis no afirma que el cambio ganará. Define qué se modifica, qué métrica debería moverse y qué evidencia sustenta la relación.
Puntuación sin falsa precisión
ICE ayuda a ordenar el backlog con tres dimensiones: impacto, confianza y facilidad. Cada criterio puede recibir una valoración interna de 1 a 10, siempre que el equipo documente qué significa cada nivel. La puntuación no predice el resultado, pero obliga a comparar ideas con un criterio común.
| Hipótesis | Impacto (1-10) | Confianza (1-10) | Facilidad (1-10) | ICE total |
|---|---|---|---|---|
| Mostrar costes de entrega antes del checkout | 9 | 8 | 7 | 504 |
| Simplificar campos del formulario B2B | 8 | 8 | 8 | 512 |
| Reordenar beneficios sobre la llamada a la acción | 6 | 6 | 9 | 324 |
| Añadir filtros visibles en categoría | 7 | 7 | 6 | 294 |
El cálculo multiplica las tres valoraciones. La cifra no debe presentarse como una verdad estadística, sino como una herramienta de decisión. La confianza sube cuando existe evidencia de sesiones, encuestas, errores técnicos o comportamiento repetido. La facilidad baja si el cambio requiere alterar catálogo, CRM, pagos o arquitectura.
Qué entra en el siguiente ciclo
Un ciclo razonable contiene pocas hipótesis y cada una debe tener una métrica primaria. Para e-commerce suele ser compra completada, ingreso por sesión o margen por visita. Para B2B, el envío de formulario no basta si la mayoría de los registros no alcanza calidad comercial. El equipo debe seguir también aceptación, respuesta, oportunidad y coste por adquisición.
Deben descartarse hipótesis que solo optimizan clics sin conexión con negocio, cambios imposibles de aislar o ideas que mezclan propuesta de valor, diseño, precio y formulario en una única variante. Una hipótesis clara permite aprender aunque el resultado sea negativo.
Herramientas clave para aplicar CRO en páginas y embudos
El stack de CRO funciona por capas. Un mapa de calor no sustituye a la analítica de eventos, y una plataforma de A/B testing no explica por sí sola por qué un usuario abandona. El equipo necesita una herramienta para observar, otra para cuantificar y otra para experimentar.
| Función | Herramientas | Cuándo usarla |
|---|---|---|
| Comportamiento visual | Hotjar, Microsoft Clarity, FullStory | Para detectar zonas ignoradas, clics repetidos y problemas de interacción |
| Analítica de eventos | GA4, Mixpanel, Heap | Para construir embudos, segmentos y recorridos medibles |
| Reproducción de sesiones | Clarity, FullStory, Hotjar | Para revisar casos reales detrás de una caída cuantitativa |
| A/B testing | VWO, Convert, AB Tasty, GrowthBook | Para comparar variantes con control, segmentación y registro de exposición |
| Experimentación técnica | Implementación propia o framework interno | Para equipos con capacidad de desarrollo y necesidades específicas |
Herramientas de comportamiento
Hotjar resulta útil para mapas de calor, encuestas y grabaciones accesibles para equipos de marketing. Microsoft Clarity ofrece una entrada práctica para revisar sesiones y patrones de interacción. FullStory encaja mejor cuando el equipo necesita una investigación más profunda de eventos, errores y recorridos.
Estas herramientas deben usarse con segmentos. Una grabación aislada no demuestra un patrón, pero varias sesiones con el mismo bloqueo pueden orientar una hipótesis. También hay que cuidar la privacidad y excluir información sensible antes de activar reproducciones.
Analítica y experimentación
GA4 sirve como base para muchos sitios, aunque necesita una arquitectura de eventos ordenada. Mixpanel y Heap pueden aportar más detalle en productos digitales o recorridos con muchas interacciones. La elección depende del modelo de negocio, del nivel de instrumentación y de quién mantendrá la medición.
VWO, Convert y AB Tasty ofrecen interfaces orientadas a equipos que necesitan lanzar experimentos con menor dependencia técnica. GrowthBook puede ser adecuado para organizaciones con una cultura más técnica y control sobre la infraestructura. Un script propio da flexibilidad, pero traslada al equipo la responsabilidad de asignación, persistencia, QA, exclusiones y análisis.
El stack mínimo debe responder a tres preguntas: qué ocurre, por qué ocurre y qué versión funciona mejor. Añadir dashboards sin responsables, eventos sin definición o tests sin control solo aumenta el ruido. La herramienta correcta es la que permite cerrar el ciclo entre evidencia, cambio y decisión.
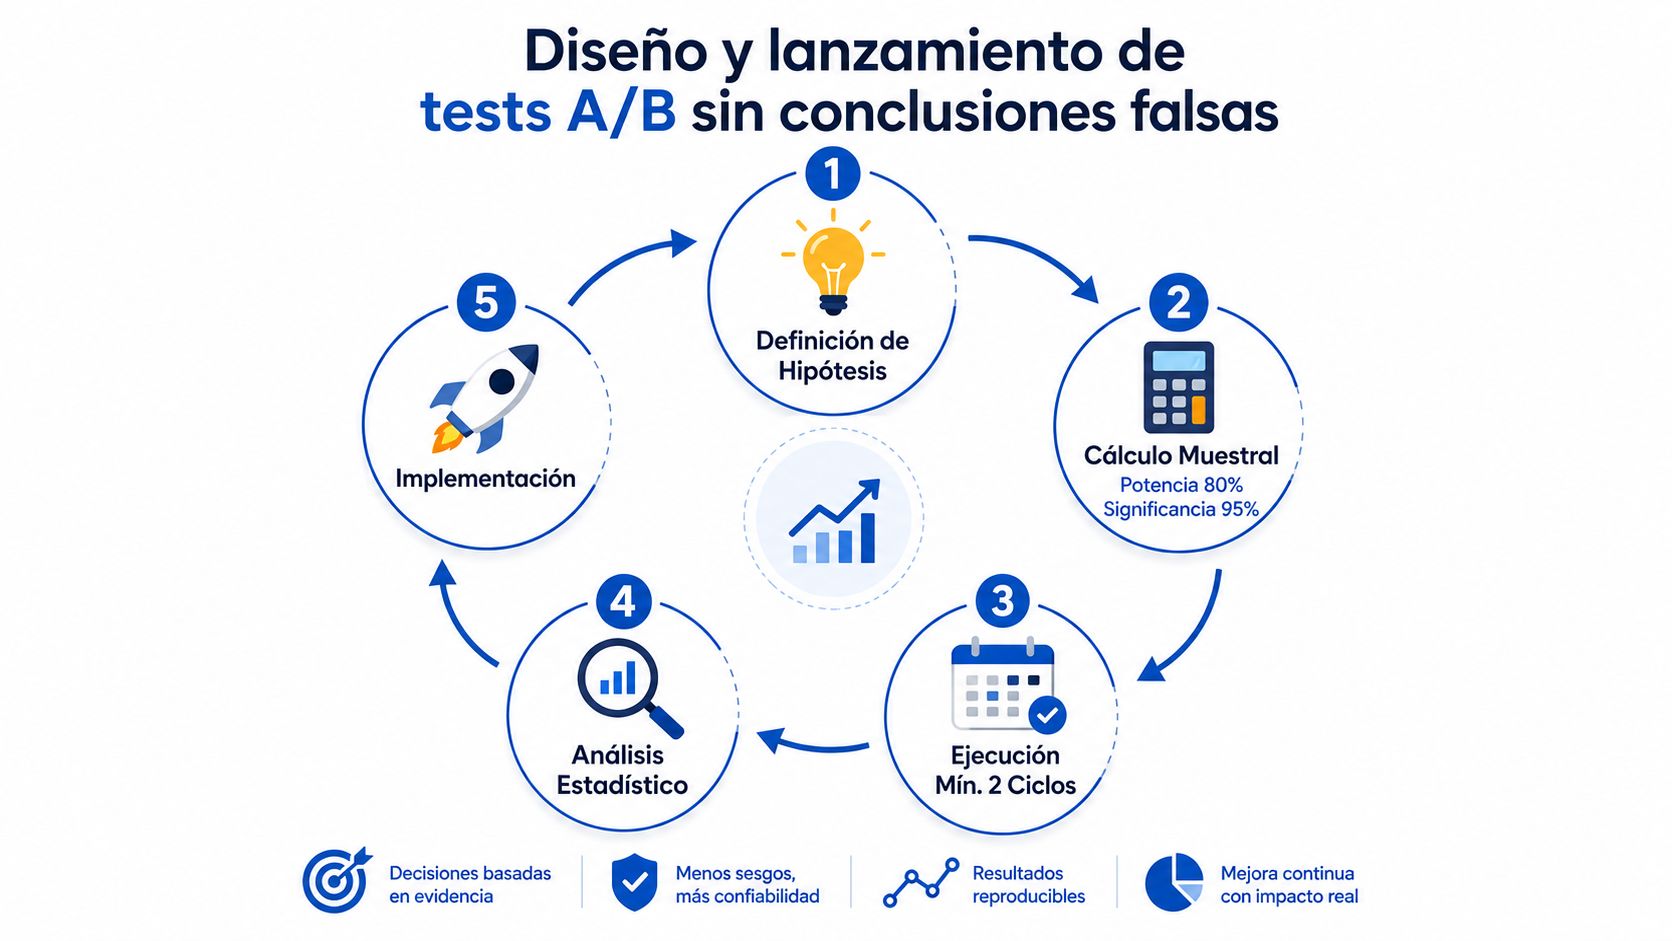
Diseño y lanzamiento de tests A/B sin conclusiones falsas
Un test A/B empieza antes de abrir la plataforma. La hipótesis debe indicar la métrica primaria, las métricas de seguridad, la audiencia, la duración prevista y la decisión asociada a cada resultado. Si el equipo decide después de mirar los datos, el experimento pierde rigor.
El tamaño muestral debe calcularse antes del lanzamiento con una potencia del 80% y una significancia del 95%, siguiendo el diseño estadístico definido para la métrica y la tasa base. No existe un tamaño universal: depende de la conversión actual, del efecto mínimo relevante y del volumen elegible.
Preparación técnica
La asignación 50/50 suele ser una opción clara cuando no hay motivo para proteger una variante. Cada usuario debe mantener su versión mediante una cookie estable o un identificador persistente compatible con el consentimiento. La plataforma debe registrar la exposición real, no solo la visita a la página.
Antes de activar el test, hay que comprobar:
- Evento primario: se dispara una vez y en el momento correcto.
- Eventos secundarios: permiten detectar daños en ingresos, leads o calidad.
- Persistencia: el usuario no cambia de variante durante el recorrido.
- Compatibilidad: la variante funciona en navegadores, dispositivos y tamaños relevantes.
- Exclusiones: se retiran empleados, tráfico interno, bots y campañas incompatibles.
- Integración: la exposición llega a la analítica y al sistema de reporting.
La orientación sobre diseño de landing pages ayuda a convertir la propuesta de valor en una experiencia que pueda medirse, no en una página cargada de elementos simultáneos. Cuando la fricción exige cambios estructurales y no solo ajustes de copy, también conviene revisar la creación y optimización de páginas web como parte del mismo recorrido.
Ejecución y reglas de parada
El test debe permanecer activo durante al menos dos ciclos de negocio para reducir el riesgo de confundir un patrón temporal con una mejora estable. No conviene detenerlo cuando aparece el primer resultado favorable ni cambiar el mensaje, el precio o la creatividad a mitad de la prueba.
El peeking, o revisión continua con parada oportunista, aumenta la probabilidad de declarar ganadora una variante por azar. La regla debe estar escrita antes: alcanzar la muestra calculada, completar la duración mínima y mantener la calidad de datos. Un resultado pequeño con poco contexto no justifica una implementación.
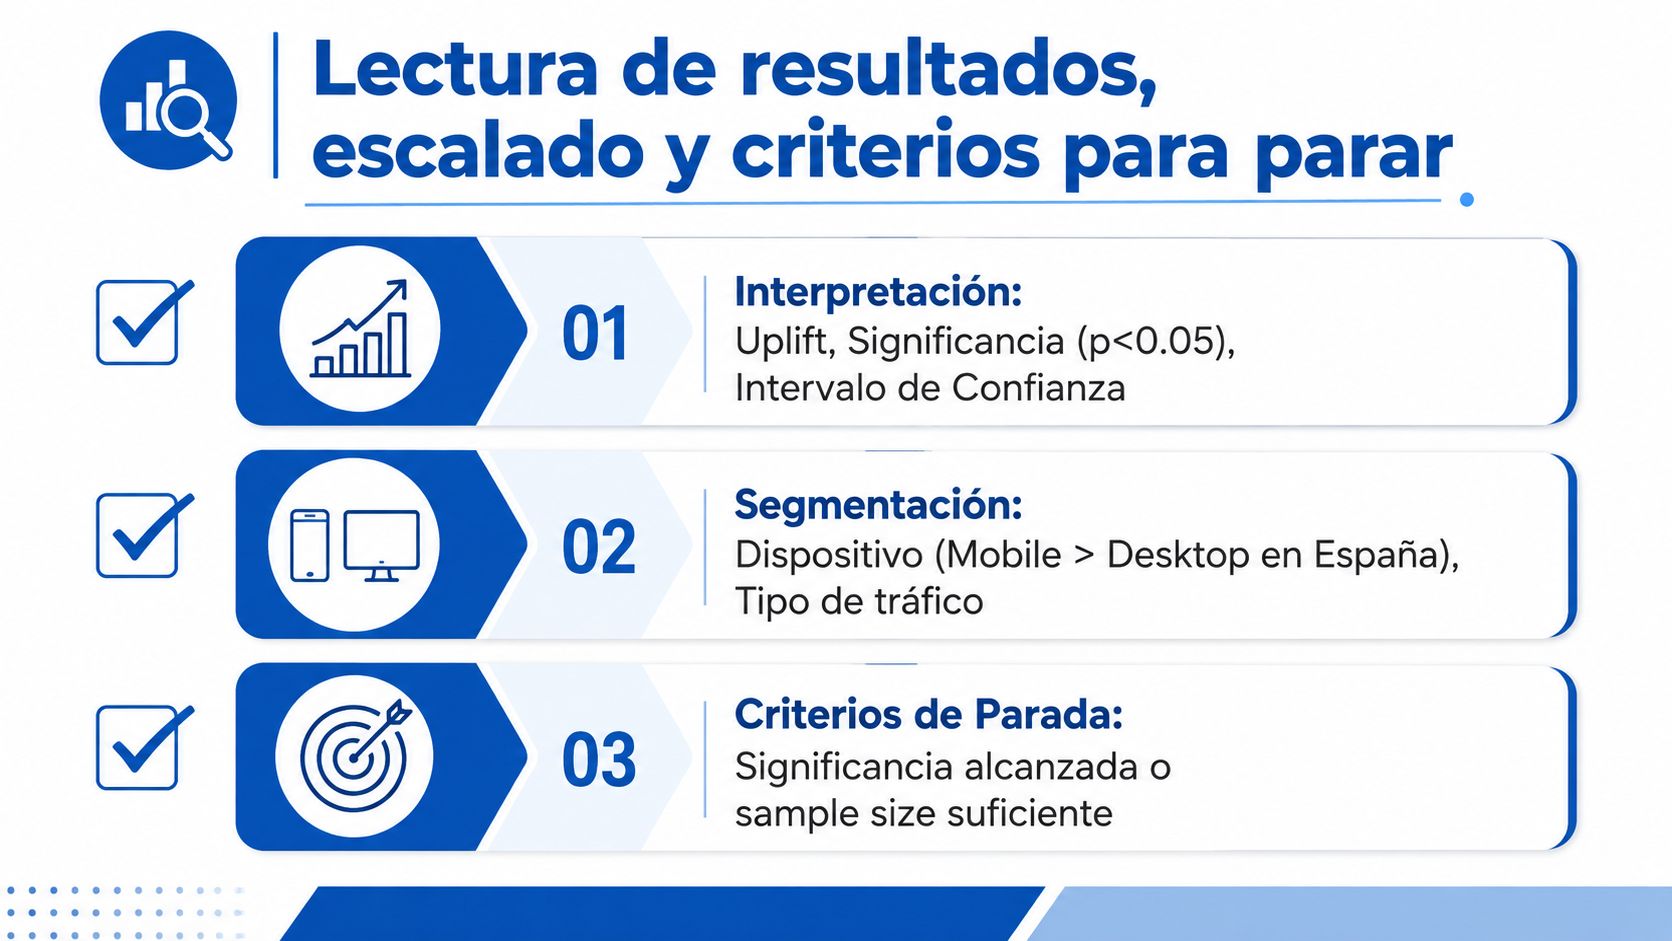
Lectura de resultados, escalado y criterios para parar
El uplift bruto no basta para decidir. Una variante puede elevar la conversión de una página y reducir el margen, la calidad del lead, la retención o el rendimiento de otra etapa. La lectura debe cruzar efecto observado, intervalo de confianza, significancia, estabilidad y consecuencia económica.
Separa siempre la métrica primaria de las métricas de protección. Si el objetivo es completar una compra, revisa ingresos por sesión, cancelaciones, devoluciones y margen cuando esos datos estén disponibles. En B2B, más formularios pueden empeorar el resultado si baja la proporción de solicitudes que el equipo comercial puede trabajar. Antes de escalar, aplica también los criterios para generar leads cualificados tras el experimento.
Segmentar sin fabricar ganadores
La segmentación sirve para diagnosticar, no para escoger ganadores después de mirar todos los cortes. Define antes del análisis los segmentos prioritarios: dispositivo, usuario nuevo o recurrente, fuente, campaña, país, categoría y cohorte temporal. Si se revisan demasiadas combinaciones, aparecerán falsos positivos.
En España, móvil y escritorio requieren una lectura separada. Una síntesis del estudio Flat 101 de 2025 publicada por ACC Ecommerce sitúa el tráfico móvil en el 66%, con una conversión media móvil del 0,82% frente al 2,02% en escritorio. La misma referencia recoge una conversión del 1,72% para usuarios recurrentes y del 1,09% para usuarios nuevos. Estos datos no justifican copiar una variante en todo el tráfico. Obligan a identificar qué fricción afecta a cada grupo.
Una variante ganadora en escritorio y neutra en móvil no se escala automáticamente. Puede exigir una experiencia específica para pantallas pequeñas, otra prueba de formulario o una revisión de velocidad y legibilidad. El dispositivo debe orientar la siguiente hipótesis, no servir como excusa para seleccionar el corte más favorable.
Decidir con negocio
Escala cuando el efecto es estadísticamente defendible, aparece en la métrica primaria, no deteriora las métricas de protección y conserva una relación aceptable con CPA, margen o calidad. Entonces la variante pasa a ser el nuevo control. La siguiente prueba debe atacar otra causa o profundizar en la misma fricción con un cambio distinto.
Itera cuando el efecto es ambiguo, pero la evidencia cualitativa sigue señalando el problema. Para cuando no hay mejora tras el diseño previsto, la variante daña móvil, reduce la calidad comercial o empeora el valor económico posterior. Registra la decisión con fecha, segmentos revisados, evidencia y siguiente acción. La regla correcta protege el margen, no solo la tasa de conversión.
Cadencia operativa y checklist final de aplicación del CRO
La aplicación del CRO necesita una cadencia que proteja el trabajo de la improvisación. Un programa trimestral puede dedicar las semanas iniciales a auditoría cuantitativa, mapas de calor y sesiones; después, el equipo prioriza hipótesis y prepara el primer lote de experimentos. Las semanas siguientes se reservan para ejecutar como máximo dos tests simultáneos, revisar calidad de datos y decidir si cada variante se escala, se itera o se descarta.
El ritual quincenal debe revisar el embudo principal, el CPA por dispositivo, la calidad de los leads, el ingreso por sesión y el aprendizaje acumulado. La reunión no debe convertirse en una exposición de dashboards. Cada dato necesita un responsable y una decisión.
Checklist de decisión
- Escalar: la variante alcanza el umbral estadístico definido, supera el efecto económico mínimo, funciona de forma consistente en los dispositivos prioritarios y no canibaliza otras páginas.
- Iterar: el resultado es ambiguo, solo aparece en un segmento o la evidencia de comportamiento confirma la fricción, pero el cambio no la resuelve por completo.
- Parar: el impacto es nulo, la variante daña confianza, reduce calidad, empeora una métrica de seguridad o no justifica el coste de desarrollo.
El programa debe cerrar cada ciclo con un registro de hipótesis, resultado, decisión y aprendizaje reutilizable. Si una prueba no puede explicar qué se ha aprendido sobre el usuario o sobre el negocio, probablemente no estaba bien planteada. El umbral de paro también debe ser explícito: si la instrumentación falla, la métrica no representa negocio o el coste de seguir supera el valor esperado, el test se detiene y se corrige la base antes de lanzar otro.
BUZZALYZE diseña y optimiza ecosistemas de captación con páginas web, SEO, campañas de Google Ads y Meta Ads, analítica y cuadros de mando orientados a leads cualificados y ROI. Si quieres transformar un diagnóstico de embudo en prioridades accionables, puedes solicitar una auditoría o contactar con el equipo para revisar páginas, adquisición y medición bajo una misma lógica.